coOCR/HTR
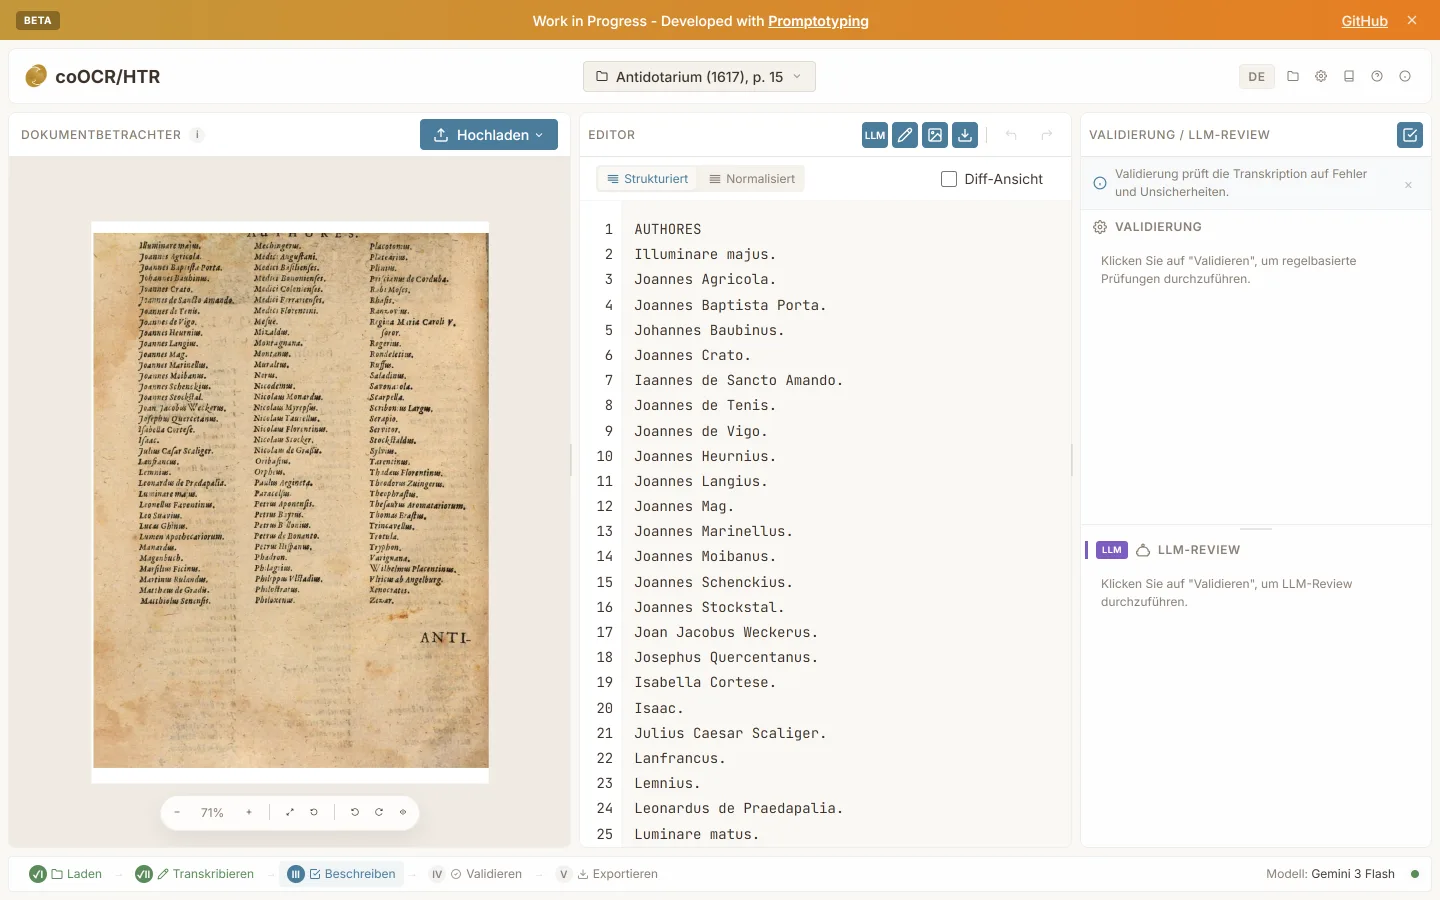
Erkennt den Text alter Drucke und Handschriften und lässt jede Lesung am Seitenbild prüfen.
Wir entwickeln mit Frontier-Sprachmodellen und Coding-Agenten Werkzeuge, Workflows und Wissensbasen für Ihre Arbeitsabläufe, im Auftrag, gemeinsam mit Ihrem Team oder im Training. Grundlage ist ein genaues Verständnis Ihres Projekts und Ihrer Daten.
In Workshops und Intensivtagen erwirbt Ihr Team die Kompetenz, selbst mit Coding-Agenten und Wissensbasen zu arbeiten.
Wir entwickeln gemeinsam mit Ihrem Team an Ihren Daten. Die Wissensbasis verbleibt bei Ihnen und ermöglicht die eigenständige Weiterentwicklung.
Wir entwickeln das Werkzeug in Ihrem Auftrag, von der kleinen Anwendung für einen einzelnen Arbeitsschritt bis zur agentischen Pipeline.
Frontier-Sprachmodelle kommen an zwei Stellen zum Einsatz, als Coding-Agenten bei der Entwicklung und im fertigen Werkzeug für einzelne Arbeitsschritte wie Texterkennung, Auszeichnung oder die Erzeugung strukturierter Daten.
In beiden Fällen kommen kommerzielle wie offene Modelle in Betracht, bis hin zum Betrieb auf eigener Hardware. Modell und Zugang werden gemeinsam mit Ihnen nach Art und Schutzbedarf der Daten gewählt. Für die Entwicklung genügen in der Regel einzelne, bei Bedarf anonymisierte Beispieldateien.
Die Abrechnung richtet sich nach der Aufgabe, nach Stunden, nach Arbeitstagen oder als Pauschale. Ausgangspunkt ist Ihr Budgetrahmen. Nach einer ersten Sichtung legen wir dar, was in diesem Rahmen möglich ist, und Sie entscheiden nach jedem Arbeitsschritt über die Fortsetzung.
Erkennt den Text alter Drucke und Handschriften und lässt jede Lesung am Seitenbild prüfen.
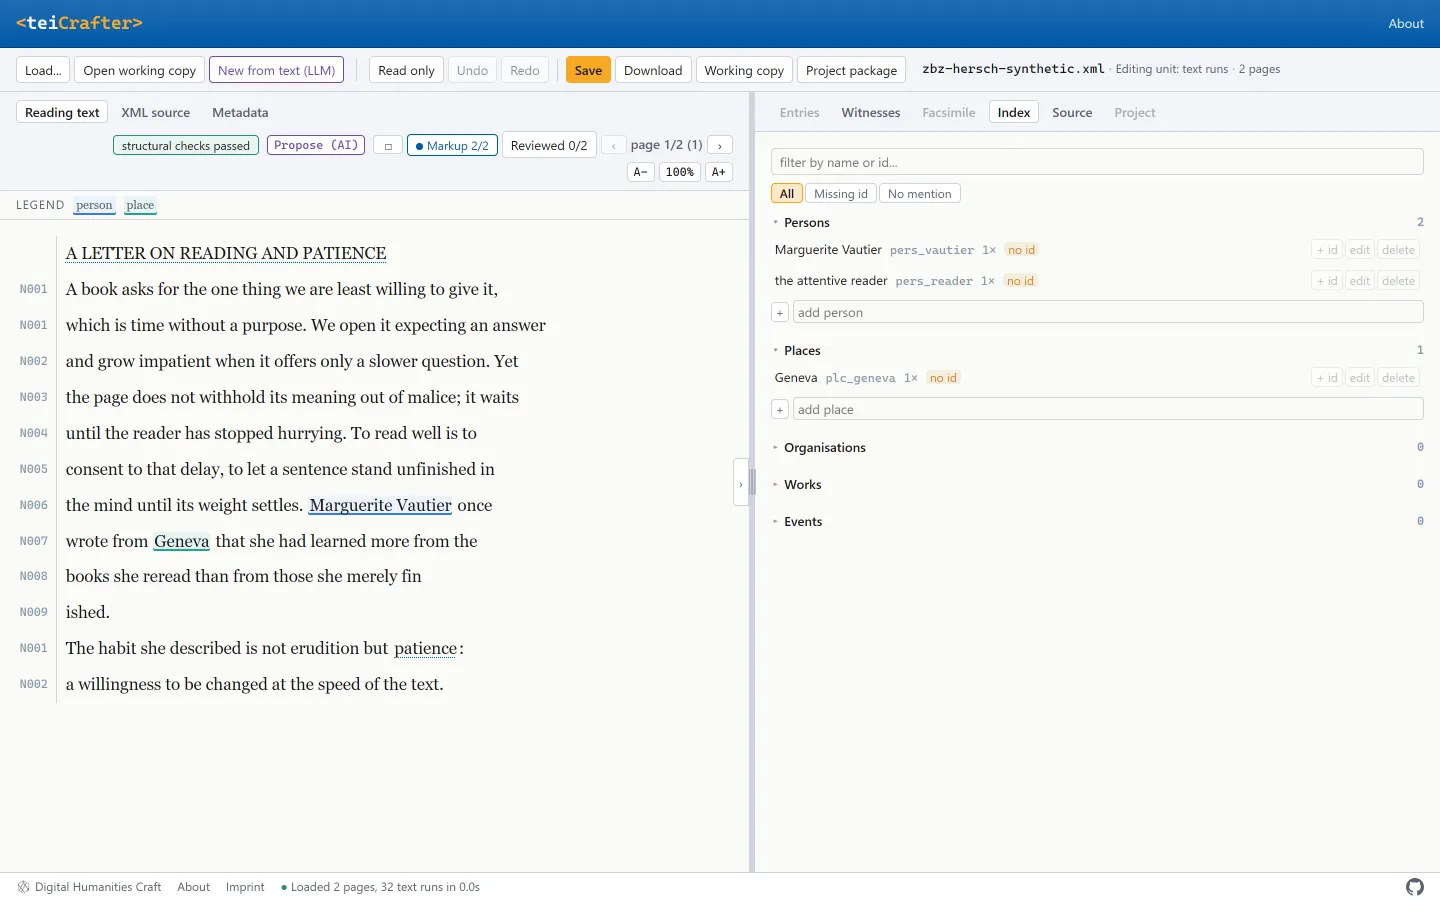
Bearbeitet TEI-XML als lesbaren Text und prüft beim Speichern gegen das Schema.
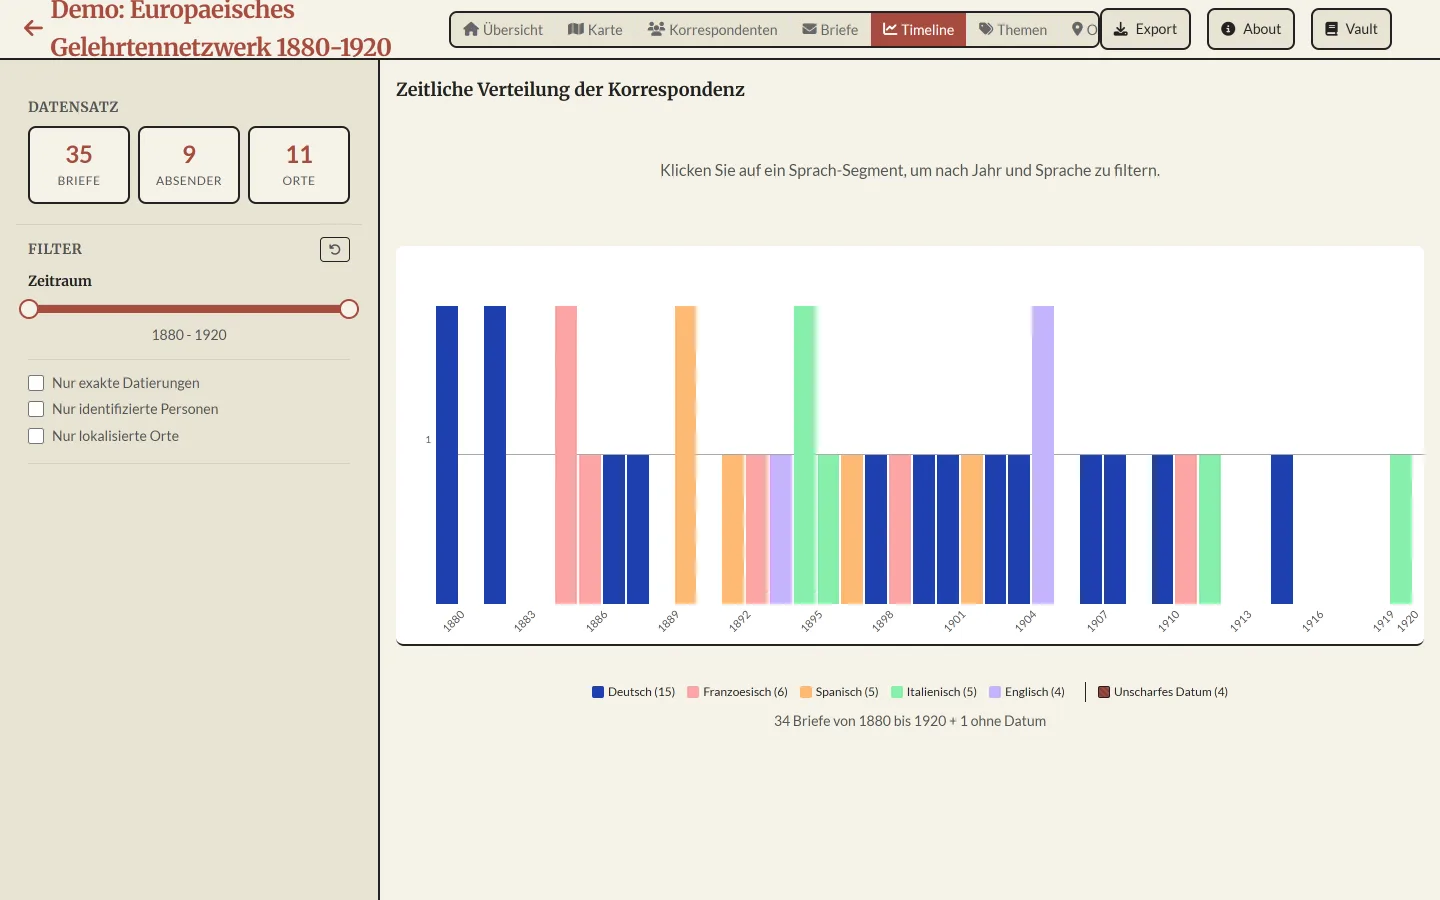
Zeigt Briefmetadaten aus CMIF als Karte, Zeitleiste und Netzwerk, damit sichtbar wird, wer wem wann von wo schrieb.
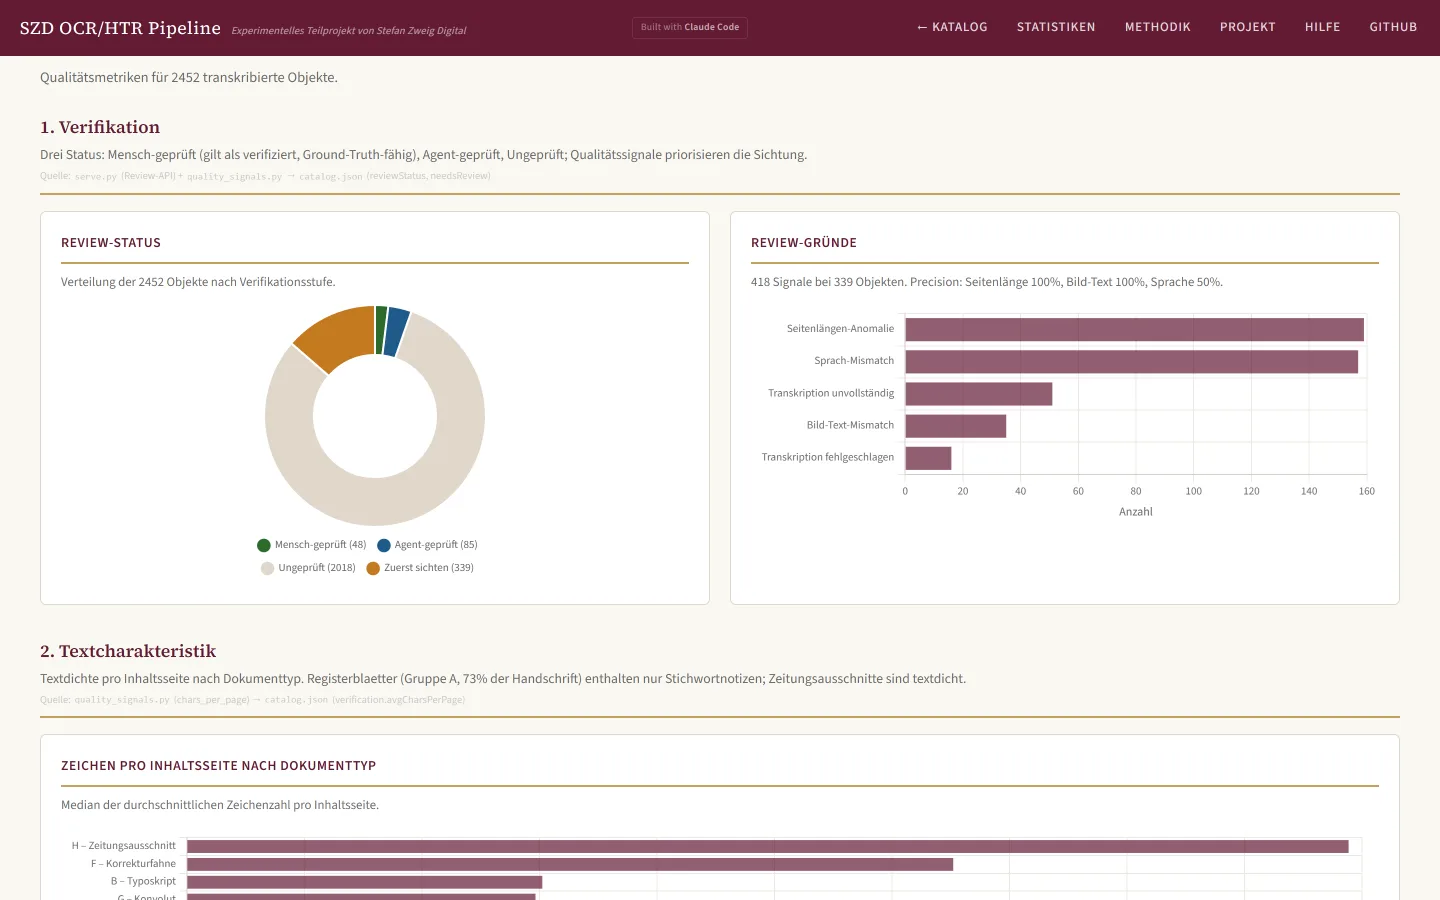
Transkribiert einen ganzen Nachlass und vermerkt an jedem Objekt, ob Maschine, Agent oder Mensch es geprüft hat.
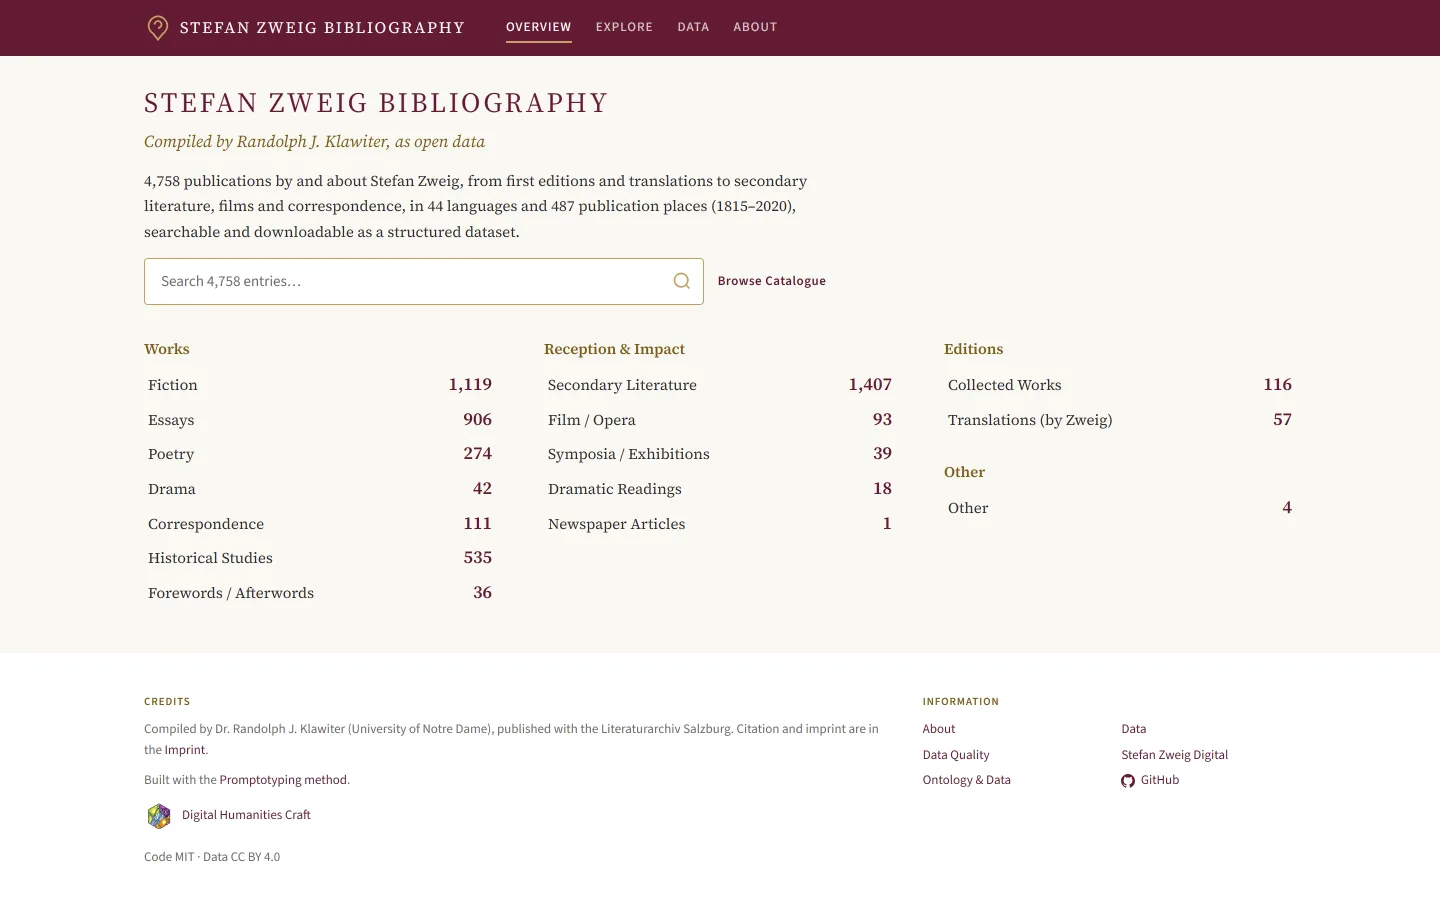
Rettet eine Bibliographie aus einem stillgelegten Wiki in Forschungsdaten, in denen jede Angabe ihre Quellseite behält.
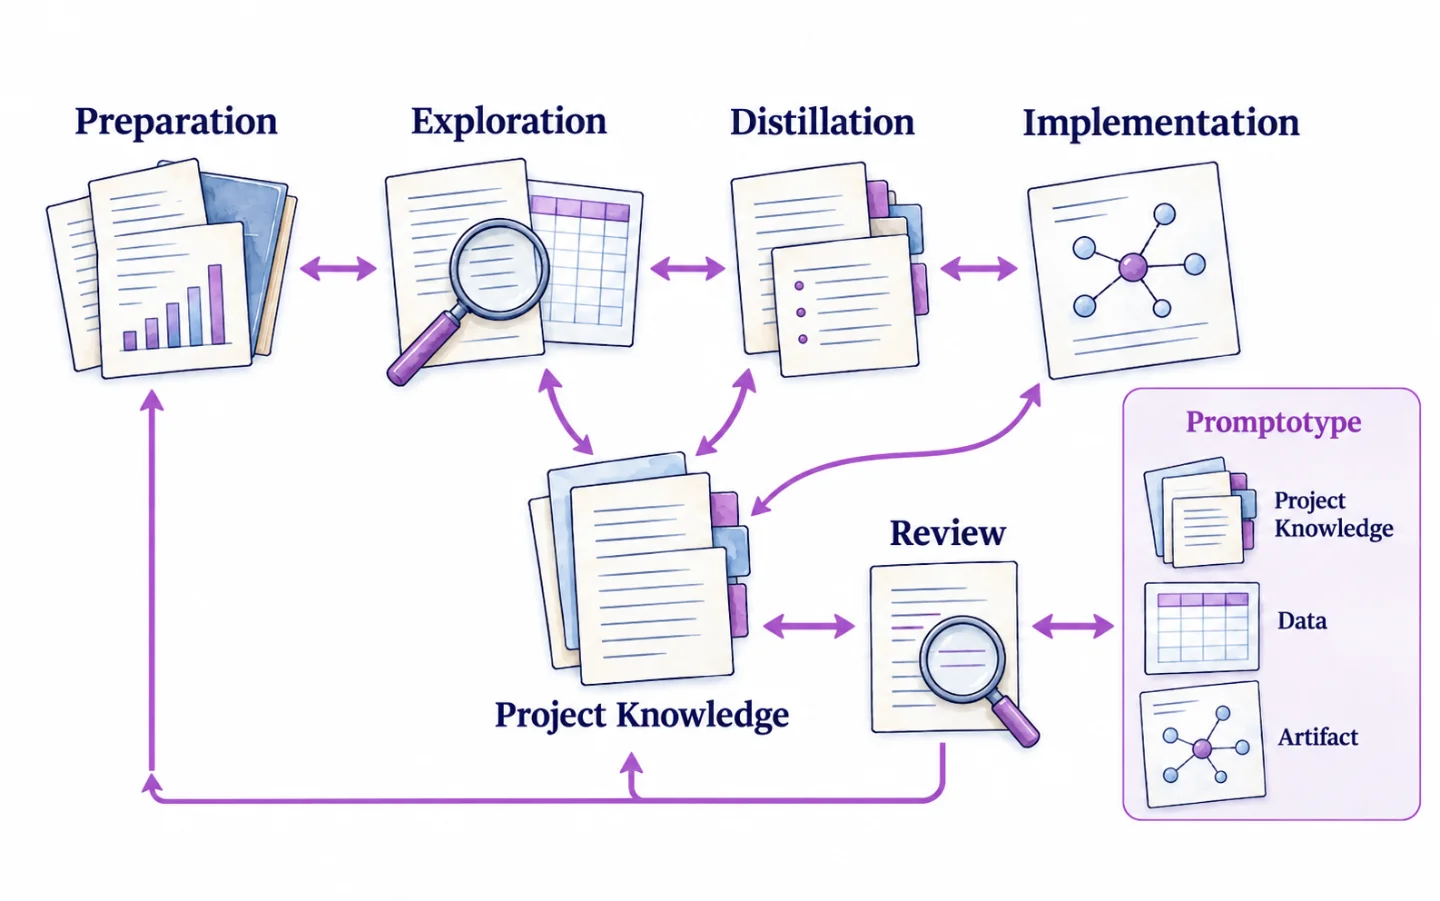
Promptotyping entwickelt Forschungsartefakte mit KI-Agenten aus einer gepflegten Wissensbasis heraus.
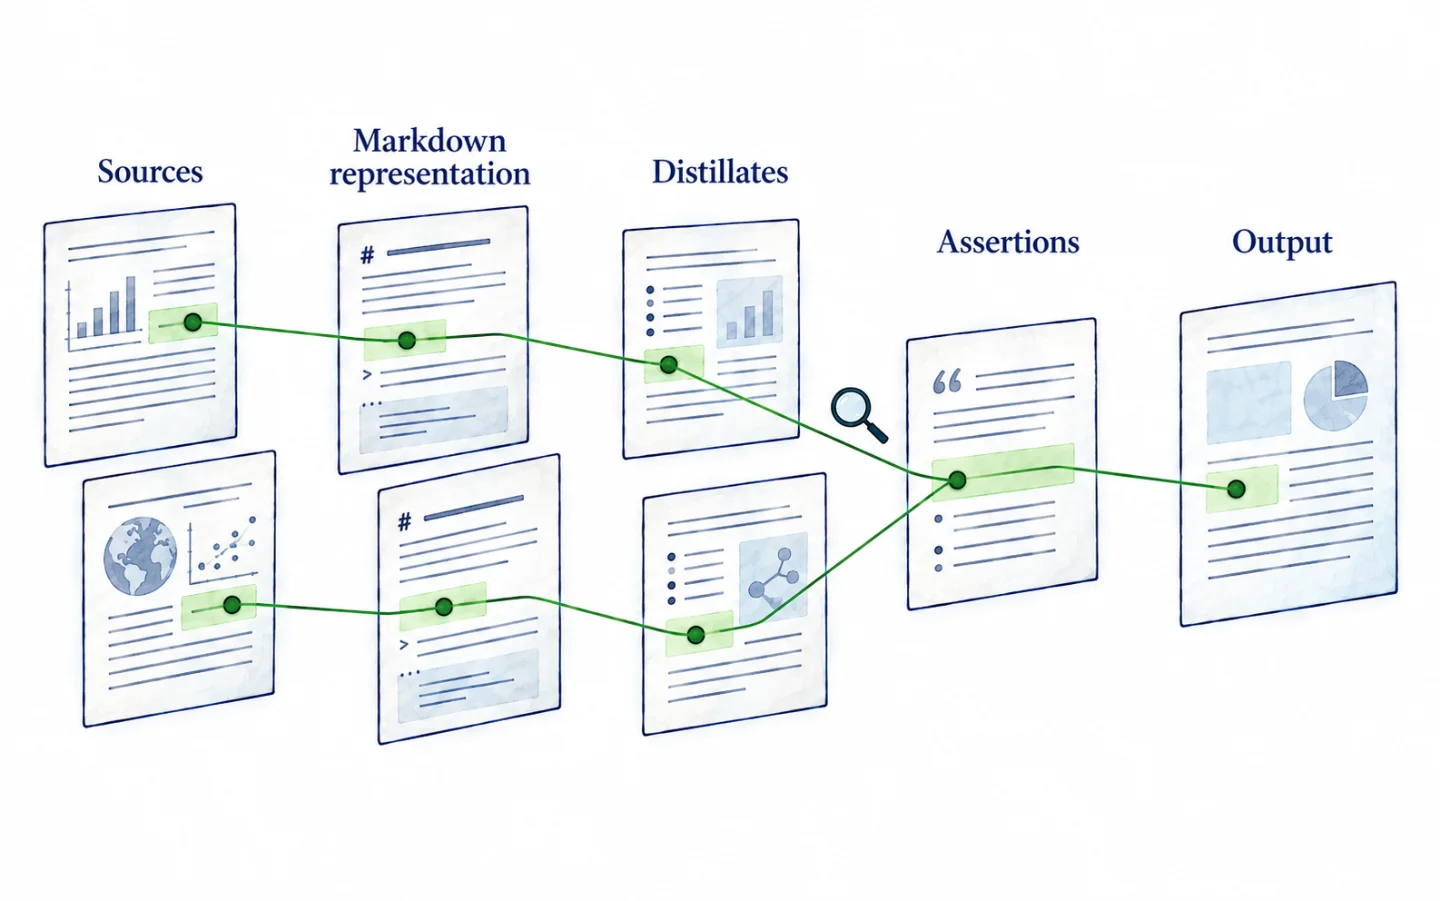
Grounded Vault führt jede tragende Aussage eines Berichts über einen prüfbaren Anker bis zur Quellstelle.
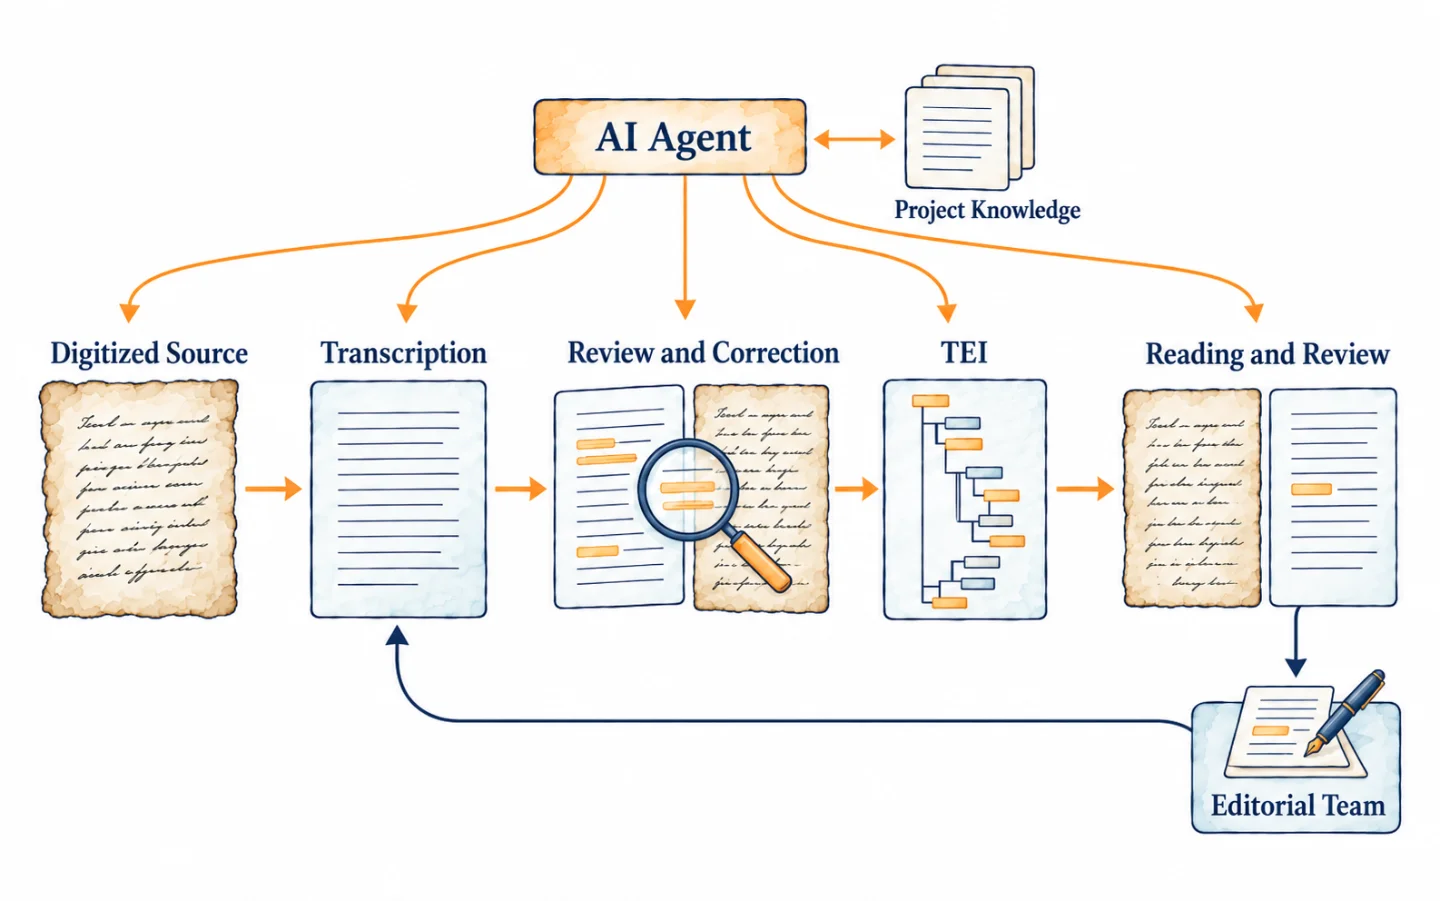
Die Agentic Edition Pipeline führt Digitalisate über Transkription und Prüfung zu TEI und einer statischen Leseansicht.
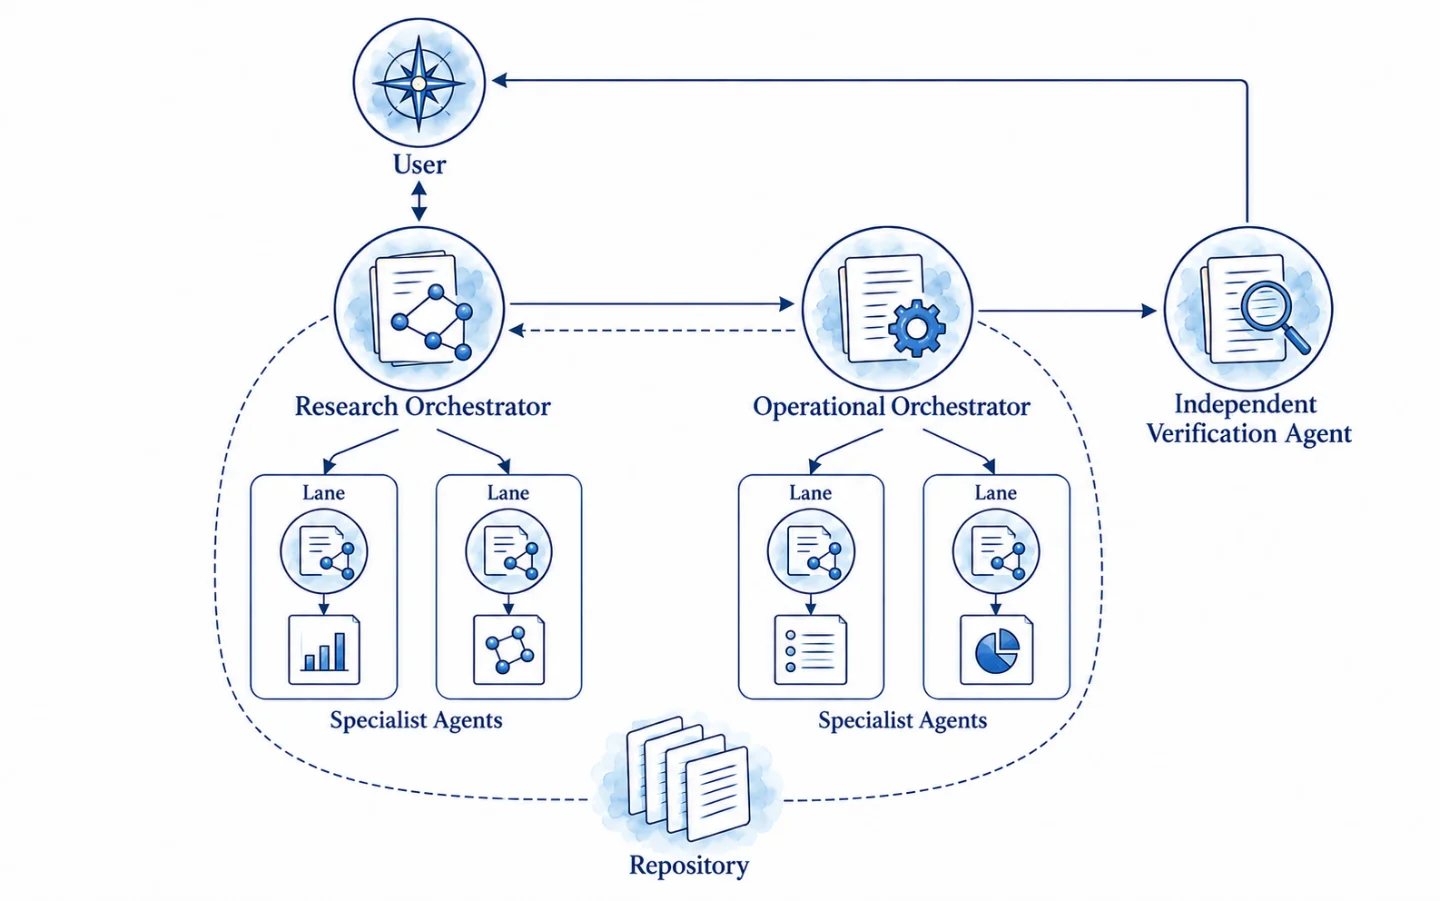
Research Mission Control verteilt Klären, Umsetzen und Prüfen auf KI-Agenten an einem gemeinsamen Repository.
Am Anfang steht das Verständnis des Projekts, seiner Fragestellung, seiner Daten und seiner Arbeitsabläufe. Dieses Wissen wird in einer projekteigenen Wissensbasis festgehalten und mit dem Code versioniert. Danach richtet sich die Methode des Context Engineering, etwa Promptotyping, Grounded Vault, eine agentische Pipeline oder ein einfacher Arbeitszyklus mit einem Agenten.
Die Qualität agentisch erzeugten Codes hängt vom Kontext ab, in dem die Agenten arbeiten. Wir gestalten diesen Rahmen aus Wissensbasis, präzisen Anforderungen, Beispieldaten aus Ihrem Bestand und automatisierten Tests, die die Agenten selbst ausführen.
Ergebnisse sind Prototypen und Forschungswerkzeuge, deren Reifegrad offen ausgewiesen wird. Für einen produktiven Betrieb, etwa mit sensiblen Daten oder vielen Nutzenden, sind eine professionelle Überarbeitung und eine unabhängige Prüfung des Codes erforderlich.
Ergebnisse liegen in offenen, dokumentierten Formaten vor, je nach Material TEI, PAGE XML, METS/MODS, JSON-LD oder CSV. Bilddaten lassen sich über IIIF einbinden. Die Daten bleiben damit unabhängig vom Werkzeug lesbar und lassen sich in andere Systeme und Repositorien überführen.
Beim Einsatz von Large Language Models bleibt für jeden Inhalt erkennbar, ob er maschinell erzeugt, von einem Agenten geprüft oder von Ihren Fachleuten bestätigt wurde. Als gesichert gelten ausschließlich fachlich bestätigte Inhalte.
Sie erhalten den vollständigen Quellcode und die Wissensbasis des Projekts, auf deren Grundlage Ihr Team, externe Entwicklerinnen und Entwickler oder KI-Assistenten die Arbeit fortführen können. Für Forschungsdaten bieten wir die Langzeitarchivierung im zertifizierten Repositorium GAMS an.
Digital Humanities Craft ist ein Unternehmen aus der Forschung der Digitalen Geisteswissenschaften mit Sitz bei Graz. Wir entwickeln Forschungssoftware und digitale Editionen, unterrichten an Universitäten in Österreich und Deutschland und arbeiten als technischer Partner in Förderprojekten. Team und Projekte
Anhand echter Dateien besprechen wir Ihren Arbeitsablauf und klären, was im vorgesehenen Rahmen möglich ist.
Ziel, Daten und Abnahmekriterien werden schriftlich festgehalten.
Eine erste lauffähige Fassung wird im Arbeitsalltag erprobt.
Ihre Fachleute prüfen das Ergebnis anhand der vereinbarten Kriterien.
Übergeben werden Werkzeug, Quellcode und Wissensbasis.
Beschreiben Sie uns kurz Ihren Arbeitsablauf. Hilfreich sind folgende Angaben:
office@dhcraft.org
Schicken Sie uns, was Sie bereits haben. Daraus bauen wir einen ersten Prototyp, an dem sich das Vorhaben konkret besprechen lässt.
office@dhcraft.org